80万颗出货!对标博通路线,国产互连芯片迎来平台化突破
12款芯片量产!80万颗出货!国产芯片迎来规模收获期
10月15日,江苏无锡,国产高性能互连芯片企业众星微召开重磅新品发布会。
现场一次性亮出12款量产芯片与系列核心IP,同时正式推出三大下一代算力基础设施新品:PCIe 6.0 Switch、800G多协议AI NIC、多模 RAID 芯片,全面覆盖AI算力、数据中心、高速互连和企业级存储等关键领域。
最具分量的数字:芯片累计出货突破80万颗。产品已经落地浪潮、中兴通讯、新华三等头部整机厂商,并在运营商、金融、互联网、电力能源等行业实现规模化部署。其中运营商场景部署存储卡超10万片,稳定运行时长超过18个月。
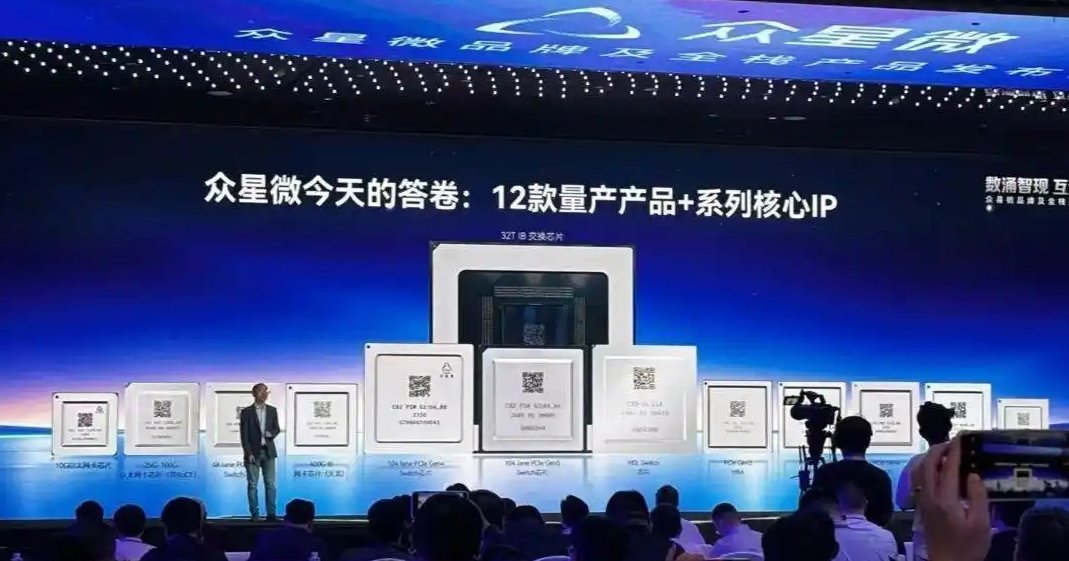
这不是一次单纯的新品发布,而是国产互连芯片从样品验证走向规模化商用,从单一芯片供应商向平台型厂商跨越的标志性一步。不少产业人士评价:众星微正在走出一条对标博通的发展路线。
很多人会问:博通(AVGO)强在哪?
博通的壁垒,从来不是某一款 “神芯片”,而是一套横跨网络、存储、PCIe 交换、高速接口的完整产品矩阵。客户搭建服务器、存储、AI 集群时,在多个关键环节都可以选用博通的芯片、IP 与配套软件方案。这是平台型半导体公司的护城河。
众星微当前的布局,正是沿着这一逻辑推进:
✅ PCIe 6.0 Switch,作为服务器内部的高速交换枢纽,连接CPU、GPU、SSD 与各类加速器,支撑AI服务器多卡扩展;
✅ 800G 多协议AI NIC,面向 AI 集群内部海量数据交互,主打高吞吐、低延迟,解决大规模算力集群网络瓶颈;
✅ 多模 RAID 芯片,服务企业级存储,保障海量 AI 数据的可靠性与读写性能。
从底层自研IP,到芯片硬件、配套软件再到系统解决方案,众星微试图打通高性能互连产业链的关键环节。
算力基础设施不再只比拼单颗芯片,而是整套系统的协同能力。
我们必须客观看待:今天的众星微,距离博通(AVGO)在全球市场份额、软件生态、全产品线积累上,仍存在巨大差距,远未到等同的阶段。但它代表了一个至关重要的产业信号:国产半导体不再只追求单点芯片突破,开始构建多产品线协同的平台化能力。
做企业级芯片,最难的从来不是流片出样。
服务器、数据中心芯片,对可靠性、兼容性、长期供货、持续技术支持有着近乎严苛的标准。一颗互连芯片一旦故障,波及的不只是一台服务器,可能是整个AI集群。漫长的客户验证周期、严苛的现场稳定性考验,是横在国产芯片面前最高的门槛。
80 万颗累计出货、十多万片存储卡长期稳定商用,这份成绩单的价值,不在于短期营收,而在于拿到了真实业务场景的工程反馈。在运营商、金融、能源这类高可靠行业持续打磨,为下一代 PCIe 6.0、800G 网卡等前沿产品迭代积累宝贵经验。
这里需要特别提示:本次发布的三款新品,并非已经全部实现规模量产,后续的客户验证、性能实测、规模化出货,仍有待持续跟踪。发布会亮相,是技术路线与产品规划的对外宣告,不等于商业化落地完成。
长期以来,国内算力产业的讨论焦点,始终是:我们能不能造出国产GPU?
这个问题当然重要。但 AI 大集群时代,一个新命题正在浮现:就算我们拥有足够多的国产算力芯片,如何让数万颗芯片高效协同、高速交换数据?
GPU是算力,互连是算力的血管。血管不通,再多算力也无法释放。
高性能互连芯片,长期处于幕后,却决定整个集群的吞吐、延迟与稳定性。PCIe 交换芯片、高速 AI 网卡、存储控制器,共同构成 AI 算力底座。这正是博通长期深耕这个赛道的核心原因。
众星微本次发布会,最大的意义,不在于 “中国博通” 的标签,而在于证明:国内已经出现本土厂商,能够在存储、PCIe 交换、AI 高速网卡多条互连主线同步推进,形成一套相对完整的产品体系。
国产算力产业,已经进入系统级竞争时代。
单芯片性能比拼是上半场;算力、网络、存储、互连、软件生态协同,才是下半场。GPU 突围的同时,高速互连、存储控制这些 “隐形基础设施”,必须同步补齐。
当然,成为真正的平台级互连巨头,是一场漫长马拉松。产品性能、生态适配、全球客户拓展、持续稳定供货,每一关都需要长期投入。
但有一点越来越清晰:
中国算力产业的下一场竞争,不仅是计算芯片之争,更是互连芯片之争。
当国产GPU开始向前突破,国产高速互连芯片也必须跟上。
而这一次,众星微已经亮出了自己的产品阵容。