把自家“印钞机”开源了!DeepSeek放出DeepInfer,直击大模型算力成本痛点
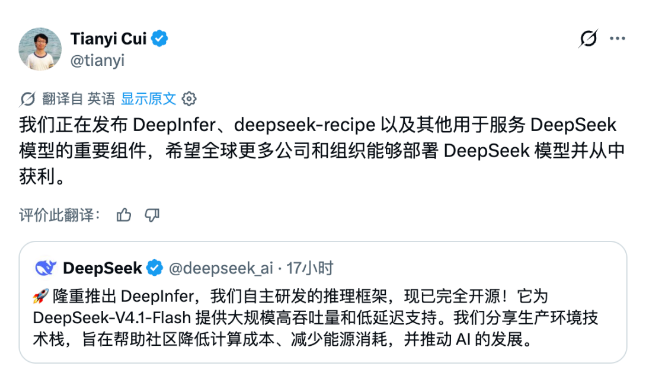
昨天,DeepSeek把自家压箱底的推理框架DeepInfer开源了!
这是其内部打磨、被称作 “印钞机” 的底层技术。
用他们自己的话说,分享内部部署经验,是帮开发者和企业优化大规模推理的吞吐与延迟,降低算力成本、减少能耗,让智能以更低的价格触达更广泛的人群,实现真正的大模型普惠。
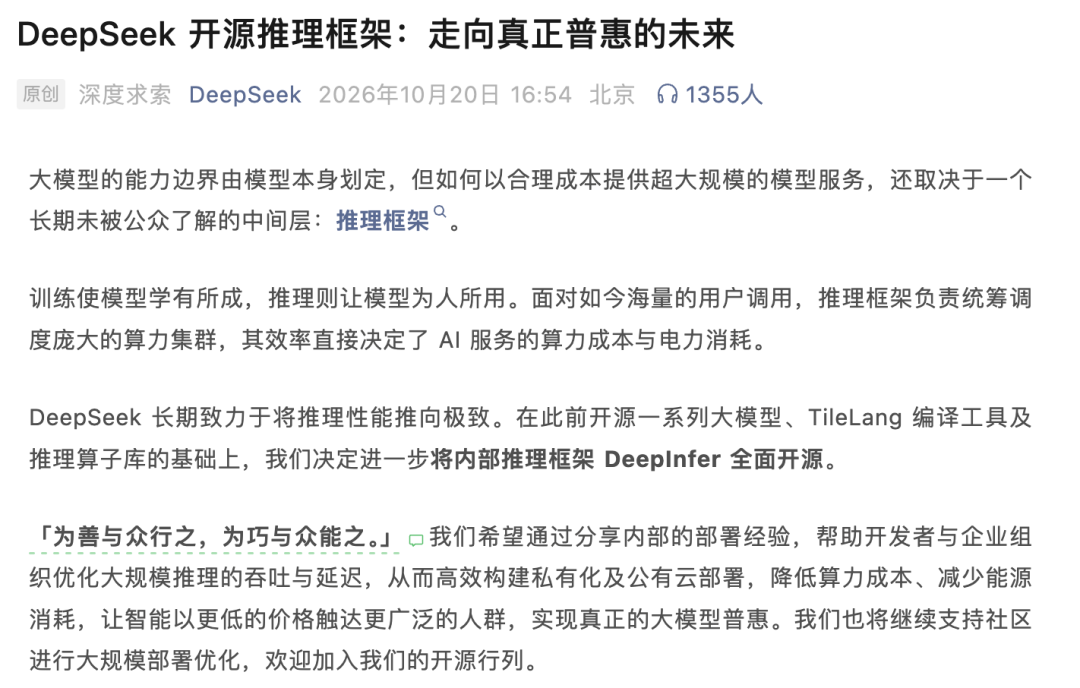
为什么这件事值得看?因为大模型的能力上限由模型决定,但能不能以合理的价格把服务提供给海量用户,靠的是中间那层几乎没人讨论的东西——推理框架。它负责调度整个算力集群,算子、通信、调度、缓存管理环环相扣,效率高低直接换算成真金白银的算力账单。
DeepInfer到底是干什么的?简单说,它是一套让大模型跑得更快、更省钱的软件。当海量用户同时向AI提问时,它负责安排计算任务、协调多张显卡协同工作,尽量减少机器空转和重复计算——同样一批机器能服务更多人,用户也能更快拿到回答。
这套框架目前已在支撑 DeepSeek V4.1 Flash 的大规模线上服务。按官方披露:单集群服务吞吐达到155万亿Tokens/天,整体收入约每卡每小时38美元(波谷价折合人民币 253.8元/卡/小时)。配合今年6月上线的峰谷定价(高峰为每天9:00–12:00、14:00–18:00,价格翻倍),这笔账算得很清楚。
为什么"跑得省"这么关键? V4.1 Flash 每回答一次问题都要消耗算力,机器利用率越高,单次请求的边际成本就越低,降价空间也就越大。这正是DeepSeek能长期维持低价API的原因之一。反过来说,很多公司下载了开源模型,却未必能做到同样的运行效率——模型能力是公开的,工程效率不是。
所以这次开源DeepInfer,等于DeepSeek把支撑低成本服务的那部分工程实现也一并交了出来。不止于此,DeepSeek还分享了一份以DeepInfer为核心的完整实践:他们究竟是如何部署、如何运行V4.1 Flash大规模推理服务的。
硬件路线同样也值得关注: DeepInfer可同时运行在英伟达与华为昇腾平台上。9 月底DeepSeek已公开面向昇腾的编程工具、计算库和通信库,华为团队参与研发支持;另有报道称其内蒙古新数据中心计划部署至少16万张昇腾950DT。
不过要泼一点冷水: 普通用户其实用不上它。技术博主宝玉指出,这套框架需要英伟达Blackwell一代数据中心卡(SM100)或昇腾950,官方性能测试用了4到64张卡,个人电脑跑不动,模型侧目前也只支持V4.1-Flash。
真正受益的是想自建部署的企业和云服务商——而且这次放出的只是"离线推理"部分,缓存对话前文的系统、读写分离的部署方式、多机之间的流量分配都还没包含,要搭成完整的线上服务仍得自己补齐。
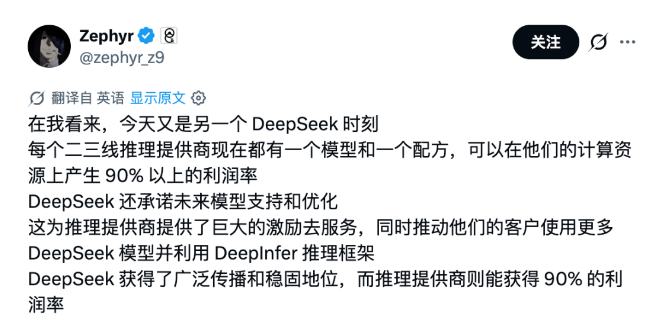
网友算了一笔账,说今天纯纯是又一个DeepSeek时刻,因为现在地球上随便一家二三线推理服务商,拿这套现成的模型和配方去跑,都能在自家算力上干出90%以上的惊人毛利。
总结一句话:模型普惠靠开源权重,服务普惠还得靠推理框架把每一分算力榨干。DeepSeek这次把后者也摊在了桌面上。